


Token Economics beschreibt die Praxis, genau zu erfassen, was eine einzelne KI-Aufgabe tatsächlich kostet, gemessen an den Tokens, die ein Modell liest und generiert. Darauf aufbauend entscheiden Sie gezielt, welche Aufgaben über gemietete Modelle laufen und welche auf einer Infrastruktur, die Sie selbst kontrollieren. So verknüpfen Sie eine technische Einheit (den Token) direkt mit einer finanziellen Größe (Ihrem KI-Budget).


Machen Sie Ihre KI-Kosten kalkulierbar
KI ist der einzige Posten in Ihrem Budget, der mit dem Geschäftserfolg wächst, ohne dass jemand sagen kann, um wie viel. Mit der Thoughtworks AI Factory ordnen Sie Workloads den passenden Modellen zu und verlagern geschäftskritische Aufgaben auf eine Infrastruktur, die Sie selbst kontrollieren. So wird aus einer variablen Anbieterrechnung ein Kostenblock, den Sie verlässlich kalkulieren und mit einem klaren ROI belegen können.
Die Herausforderung
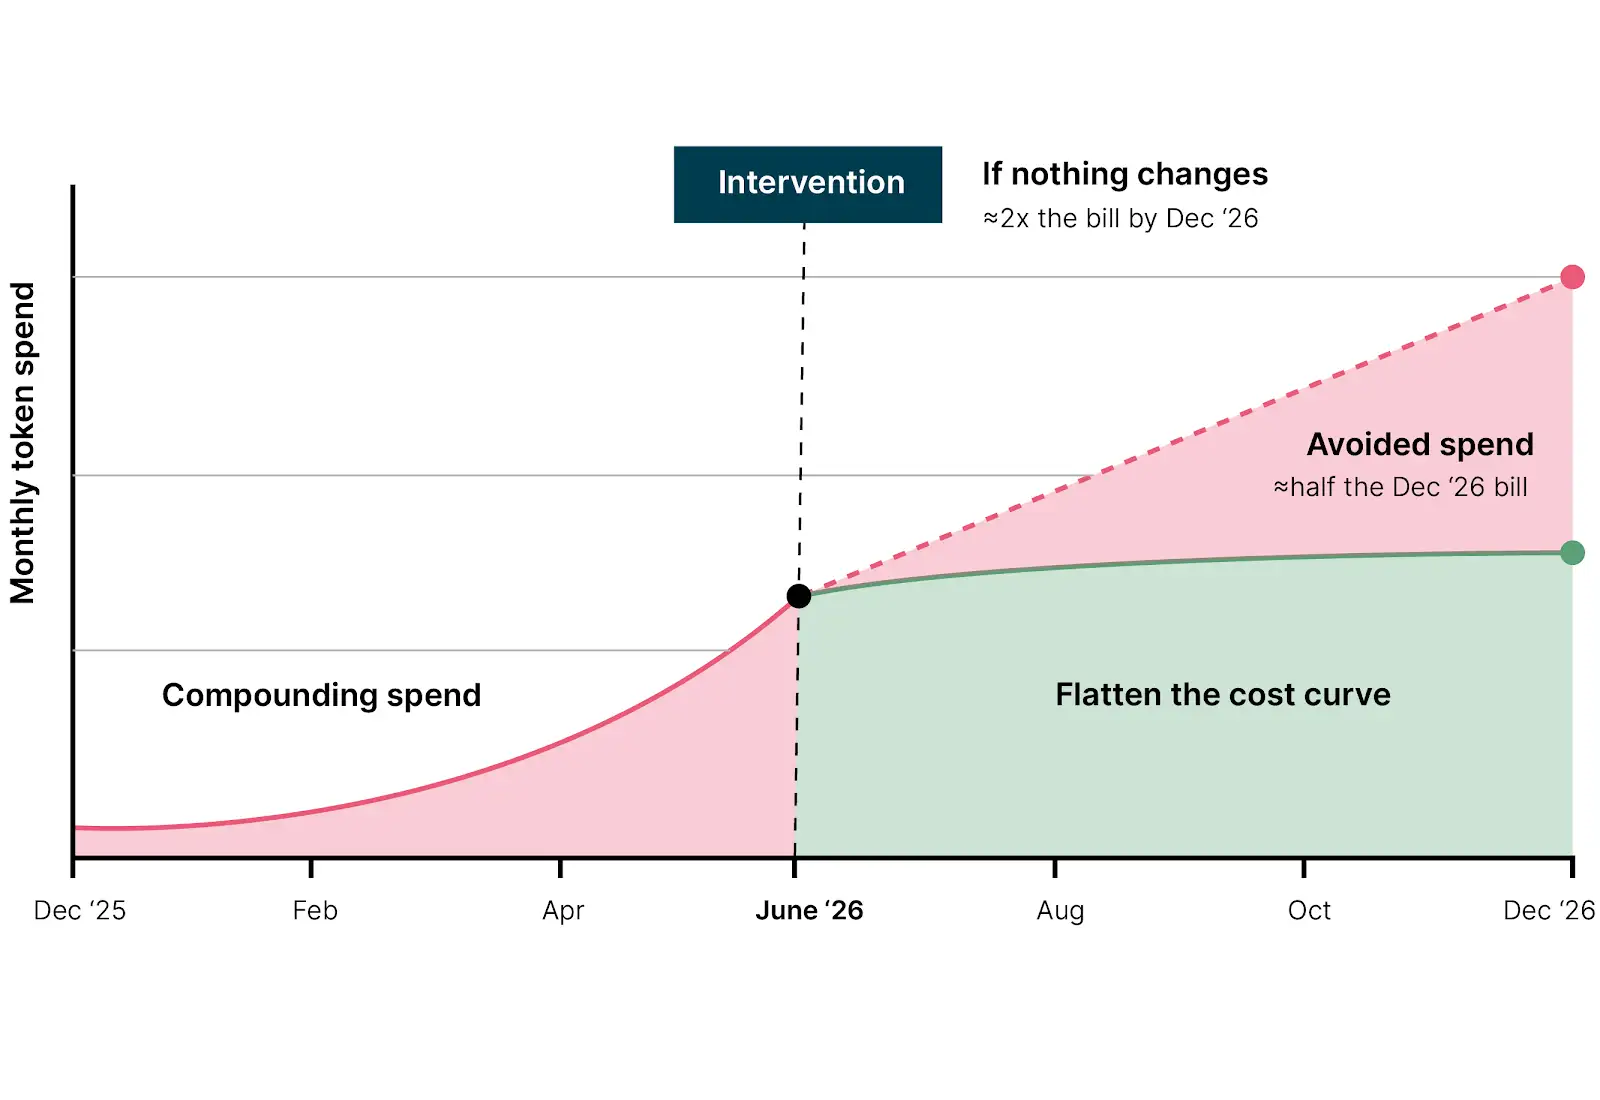
Token-Ausgaben steigen nicht linear
Sobald Teams im Arbeitsalltag auf KI setzen, wächst die Nutzung Monat für Monat. Ohne aktive Steuerung verläuft diese Kurve exponentiell. Wenn Sie nichts unternehmen, können sich die laufenden Kosten innerhalb eines Jahres erneut verdoppeln.
Die Ausgaben selbst sind nicht das Problem. Ausgaben ohne Plan schon. Sobald Sie wissen, welche Aufgaben wirklich Ihre teuersten Modelle erfordern und welche nicht, steuern Sie Ihre Workloads gezielt, statt standardmäßig für alles Spitzenpreise zu zahlen. Ihre Rechnung wächst zwar weiter, wenn Sie mehr mit KI umsetzen. Aber sie wächst zu Ihren Bedingungen.
Wenn Sie das hier lesen, befinden Sie sich wahrscheinlich gerade in einer von drei Situationen:
Wie wir Kunden unterstützen
Analyse
Wir zeigen Ihnen, wohin Ihre Token-Ausgaben fließen: welche Modelle welche Workloads bedienen, was jeder einzelne pro Ergebnis kostet und wo Sie Preise für Frontier Models zahlen, obwohl die Aufgabe diese gar nicht erfordert. Sie gewinnen ein klares Bild Ihrer Ausgaben.
Strategie und Roadmap
Gemeinsam mit Ihrem Team entscheiden wir, welche Workloads auf andere Modelle wechseln und welche bleiben sollten, und legen für jeden Kosten- und Qualitätsziele fest. Die Roadmap definiert die Reihenfolge inklusive Verantwortlichkeiten und erwarteten Einsparungen.
Thin-Slice Proof of Concept
Wir belegen den Ansatz anhand eines konkreten Workloads mit relevanten Ausgaben. Dabei messen wir Kosten und Qualität gegen Ihre eigene Ausgangsbasis, sodass Sie die Wirkung sehen, bevor Sie umfassender investieren.
Laufender Betrieb
Da sich Preise und Modelle ständig ändern, bleibt die optimale Lösung für einen Workload nicht dauerhaft optimal. Wir übergeben Ihnen einen Managed Service, der Ihre Kosten pro Ergebnis senkt, während sich der Markt weiterentwickelt, sei es als Subscription, über Plattformen und Tooling, mit dedizierten Fachleuten oder als Kombination daraus.
Aktuelle Forschungsergebnisse
Von Thoughtworks AI LabsWer Modelle auswählt oder wechselt, braucht belastbare Erkenntnisse darüber, wie sie sich unter realen Bedingungen verhalten. Thoughtworks AI Labs untersuchen Modellevaluierung, Interpretierbarkeit, Robustheit und Steuerbarkeit. Unsere Forschenden veröffentlichen ihre Ergebnisse sowie, sofern verfügbar, Code und Datensätze, damit andere die Methoden prüfen und darauf aufbauen können.
Unsere Arbeit umfasst über 1.000 Experimente dazu, wie sich Änderungen an einer Anfrage auf Retrieval-Augmented Generation (RAG) auswirken, einschließlich Publikationen auf Konferenzen wie NeurIPS, ICLR, AAAI, ACL, EMNLP und IEEE.
FAQ
-
-
Sobald ein Workload ein hohes Volumen erreicht und stabil läuft, rechnet sich der Preisaufschlag geschlossener APIs oft nicht mehr. Eine Fehlallokations-Analyse (Misallocation Audit), bei der die Ausgaben gezielt nach einzelnen Workloads aufgeschlüsselt werden, liefert Ihnen am schnellsten Klarheit.
-
Einen pauschalen Richtwert gibt es nicht, da die Summen stark vom Workload-Mix und dem jeweiligen KI-Reifegrad eines Unternehmens abhängen. Unserer Erfahrung nach liegt der Kipppunkt für einen einzelnen Workload meist zwischen 250.000 und 500.000 US-Dollar pro Jahr. Viele Unternehmen haben diese Schwelle bei Dutzenden von Workloads bereits vor über einem Jahr überschritten.
-
In unseren Projekten zielen wir bei KI-gestützter Programmierung typischerweise auf eine Kostensenkung von über 30% ab. Gemessen wird das an den Kosten pro abgeschlossener Aufgabe, wobei die Qualität gegenüber Ihrer Ausgangsbasis verlässlich abgesichert bleibt.
-
Die Token-Kostenoptimierung ist der schnellste und klar abgegrenzte Einstieg, denn sie optimiert, worauf ein Workload heute läuft. Die AI Factory hingegen ist das umfassende Betriebsmodell: mit Gateway, gesteuertem Multi-Model-Serving und der nötigen Infrastruktur, um bei wachsendem Volumen immer mehr eigene KI-Kompetenz im Haus zu behalten.